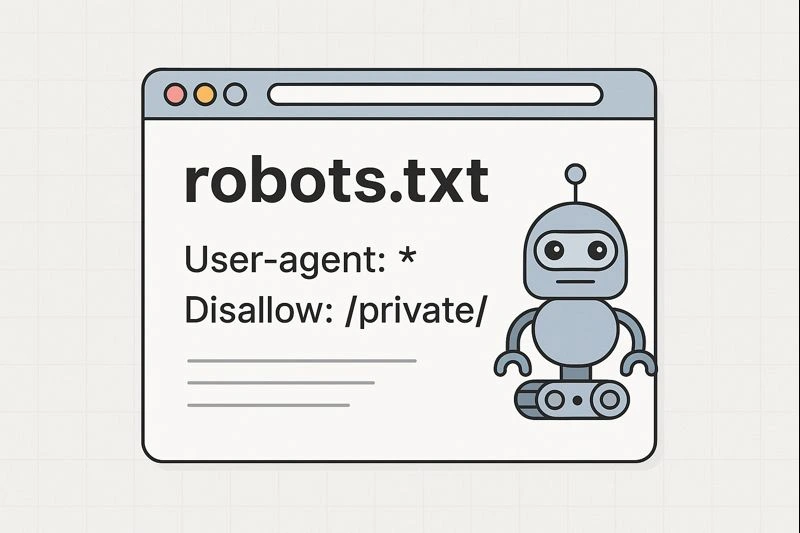
Sebuah website bisa memiliki banyak halaman dengan fungsi yang berbeda. Ada halaman yang ingin pemilik situs tampilkan di mesin pencari, tetapi ada juga bagian tertentu yang tidak perlu crawler jelajahi. Dalam kondisi tersebut, pengelola website bisa menggunakan robots.txt untuk memberikan aturan kepada crawler.
Robots.txt merupakan file teks sederhana yang berada pada bagian utama sebuah website. File ini berisi aturan yang memberi petunjuk kepada crawler mengenai bagian website yang boleh atau tidak boleh mereka akses.
Memahami fungsi robots.txt dalam mengatur crawler membantu pengelola website mengelola proses crawling dengan lebih terarah. Namun, file ini juga memiliki batasan sehingga pengelola harus memahami cara kerjanya sebelum membuat aturan.
Apa Itu Robots.txt?
Robots.txt adalah file yang berisi instruksi untuk crawler atau robot mesin pencari. Crawler membaca file tersebut ketika mulai mengunjungi sebuah website, kemudian mengikuti aturan yang tersedia.
File ini biasanya berada pada direktori utama domain. Sebagai contoh, sebuah website bisa memiliki alamat robots.txt pada:
https://contohwebsite.com/robots.txt
Isi file menggunakan format tertentu untuk menentukan crawler dan jalur halaman yang ingin pengelola atur. Pengelola bisa membuat aturan yang berbeda untuk crawler tertentu atau menggunakan aturan umum.
Mengapa Website Membutuhkan Robots.txt?
Tidak semua bagian website memiliki manfaat yang sama bagi mesin pencari. Beberapa halaman hanya berfungsi untuk kebutuhan internal, seperti halaman administrasi, area pencarian internal, atau direktori tertentu.
Robots.txt membantu pengelola memberikan petunjuk kepada crawler agar tidak mengakses bagian yang tidak ingin mereka jelajahi.
Contohnya, sebuah website memiliki direktori /admin/. Pengelola bisa membuat aturan yang meminta crawler untuk tidak mengakses direktori tersebut.
Dengan cara ini, pengelola bisa mengatur ruang lingkup crawling sesuai struktur website.
Cara Robots.txt Mengatur Crawler
Robots.txt menggunakan beberapa perintah sederhana. Salah satunya adalah User-agent, yang menentukan crawler yang menerima aturan.
Perintah Disallow kemudian menentukan jalur yang tidak ingin pengelola izinkan untuk crawler.
Contoh sederhana:
User-agent: *
Disallow: /admin/
Tanda * menunjukkan bahwa aturan berlaku untuk semua crawler yang mengikuti standar robots.txt. Sementara itu, /admin/ menunjukkan direktori yang ingin pengelola batasi.
Pengelola juga bisa menggunakan Allow untuk memberikan akses pada jalur tertentu ketika struktur aturan membutuhkan pengecualian.
Robots.txt Bukan Alat untuk Menghapus Halaman dari Google
Bagian ini penting karena banyak orang masih salah memahami fungsi robots.txt. File tersebut mengatur akses crawler, tetapi tidak menjadi cara utama untuk menghapus halaman dari indeks Google.
Jika sebuah halaman sudah Google ketahui melalui sumber lain, URL tersebut masih mungkin muncul dalam hasil pencarian meskipun robots.txt membatasi crawling. Dalam kondisi tertentu, Google bisa menampilkan URL tanpa mengambil isi halaman secara lengkap.
Karena itu, pengelola harus memilih metode yang sesuai dengan tujuan. Jika ingin mengatur apakah halaman masuk indeks, pengelola perlu mempertimbangkan mekanisme lain seperti pengaturan noindex pada halaman.
Hubungan Robots.txt dengan Proses Crawling
Crawler memiliki sumber daya terbatas ketika menjelajahi website. Website dengan ribuan atau bahkan jutaan URL membutuhkan pengelolaan crawling yang lebih terstruktur.
Robots.txt dapat membantu pengelola memberi petunjuk mengenai area yang tidak perlu crawler akses. Misalnya, website memiliki halaman dengan parameter URL yang menghasilkan banyak variasi serupa.
Dengan aturan yang tepat, pengelola bisa mengurangi aktivitas crawler pada bagian yang kurang penting. Namun, aturan tersebut harus tetap mempertimbangkan kebutuhan mesin pencari untuk menemukan halaman utama dan konten penting.
Robots.txt Harus Menggunakan Aturan yang Tepat
Kesalahan dalam membuat robots.txt bisa memberikan dampak pada proses crawling. Jika pengelola tanpa sengaja memblokir direktori yang berisi halaman penting, crawler mungkin kesulitan mengakses halaman tersebut.
Karena itu, periksa setiap aturan sebelum menerapkannya. Jangan memasukkan terlalu banyak jalur ke dalam Disallow tanpa memahami hubungan halaman tersebut dengan struktur website.
Pengelola juga bisa memeriksa file robots.txt secara berkala ketika melakukan perubahan besar pada website.
Hubungan Robots.txt dengan Sitemap
Sitemap membantu mesin pencari menemukan URL penting dalam website, sedangkan robots.txt memberikan petunjuk mengenai akses crawler.
Keduanya memiliki fungsi berbeda, tetapi bisa bekerja dalam satu pengelolaan teknis. Pengelola dapat mencantumkan alamat sitemap dalam robots.txt agar crawler lebih mudah menemukan lokasi sitemap.
Contohnya:
Sitemap: https://contohwebsite.com/sitemap.xml
Pengaturan tersebut membantu crawler menemukan sumber URL yang sudah pengelola susun dalam sitemap.
Periksa Robots.txt Secara Berkala
Struktur website bisa berubah ketika pengelola menambah kategori, memindahkan halaman, atau melakukan migrasi. Perubahan tersebut bisa membuat aturan lama tidak lagi sesuai.
Karena itu, lakukan pemeriksaan setelah perubahan besar pada website. Pastikan aturan tetap membatasi area yang memang ingin dikelola tanpa menghalangi halaman penting.
Google Search Console juga bisa membantu pengelola memantau berbagai informasi terkait crawling dan kondisi halaman.
Kesimpulan
Fungsi robots.txt dalam mengatur crawler berkaitan dengan pemberian petunjuk mengenai bagian website yang boleh atau tidak boleh crawler akses. File ini membantu pengelola mengarahkan aktivitas crawler, terutama pada website yang memiliki banyak halaman dan struktur kompleks.
Namun, robots.txt bukan alat utama untuk menghapus halaman dari indeks Google. Pengelola harus memahami perbedaan antara mengatur crawling dan mengatur indexing agar tidak salah menerapkan aturan.
Dengan struktur robots.txt yang tepat, sitemap yang terarah, serta pemeriksaan teknis secara berkala, pengelola bisa menjaga proses crawling tetap sesuai kebutuhan website. Jika membutuhkan dukungan untuk mengelola aspek SEO secara lebih menyeluruh, jasa seo website dapat membantu menyesuaikan strategi dengan kondisi situs.
Rahma Yani adalah seorang pelajar yang memiliki minat di bidang SEO dan digital marketing serta aktif mempelajari strategi optimasi untuk meningkatkan visibilitas website di mesin pencari.